So bauen Sie einen KI-Chatbot mit LangChain und RAG
Ich baue einen RAG-Chatbot mit LangChain in einer Python-Datei und erkläre jeden Teil, vom Chunking und Retrieval bis zur Tool-Schleife und zum Streaming.
Ich entwickle die Open-Source-KI-Chatbot-Engine, auf der ChatFrom läuft. Sie beantwortet Fragen von Kunden aus den eigenen Hilfeseiten jedes Unternehmens und ist auf LangChain und LangGraph gebaut. In dieser Engine erledigen zwei Teile den Großteil der Arbeit. Der erste findet die Stellen in Hilfeseiten und Dokumentation, die zur Frage des Kunden passen. Der zweite lässt das Modell bei den eigenen Systemen des Unternehmens nachfragen, was Hilfeseiten und Dokumentation nicht wissen können, etwa ob eine Rechnung bezahlt ist.
In diesem Beitrag baue ich beide von Grund auf in einer Python-Datei. Die fertigen Chains und Agents von LangChain nutze ich hier nicht, weil jede Nachricht, die an das Modell geht, im Code sichtbar sein soll. Die fertigen Versionen lassen sich leichter übernehmen und viel leichter debuggen, wenn man einmal gesehen hat, was sie tun.
Das Beispiel ist ein Support-Chatbot für ein erfundenes Unternehmen für Rechnungssoftware namens Ledgerbird, mit sechs Markdown-Hilfeseiten zu Tarifen, Abrechnung und Erstattungen. Sie brauchen Python 3.10 oder neuer und einen API-Schlüssel von OpenRouter.
Was wir bauen
Am Ende kann das Skript fünf Dinge.
- Es teilt Ihre Markdown-Hilfeseiten an ihren Überschriften in Chunks und speichert sie in Chroma.
- Zu jeder Frage findet es die fünf Chunks, die am besten passen, und lässt alle weg, die zu schwach passen.
- Das Modell antwortet nur aus diesen Chunks und sagt, von welcher Seite jede Antwort stammt.
- Das Modell kann eine Ihrer Funktionen aufrufen,
invoice_status, und eine kurze Schleife, die Sie selbst schreiben, führt diesen Aufruf aus. - Folgefragen macht es vor der Suche zu vollständigen Fragen, und es zeigt die Antwort Wort für Wort.
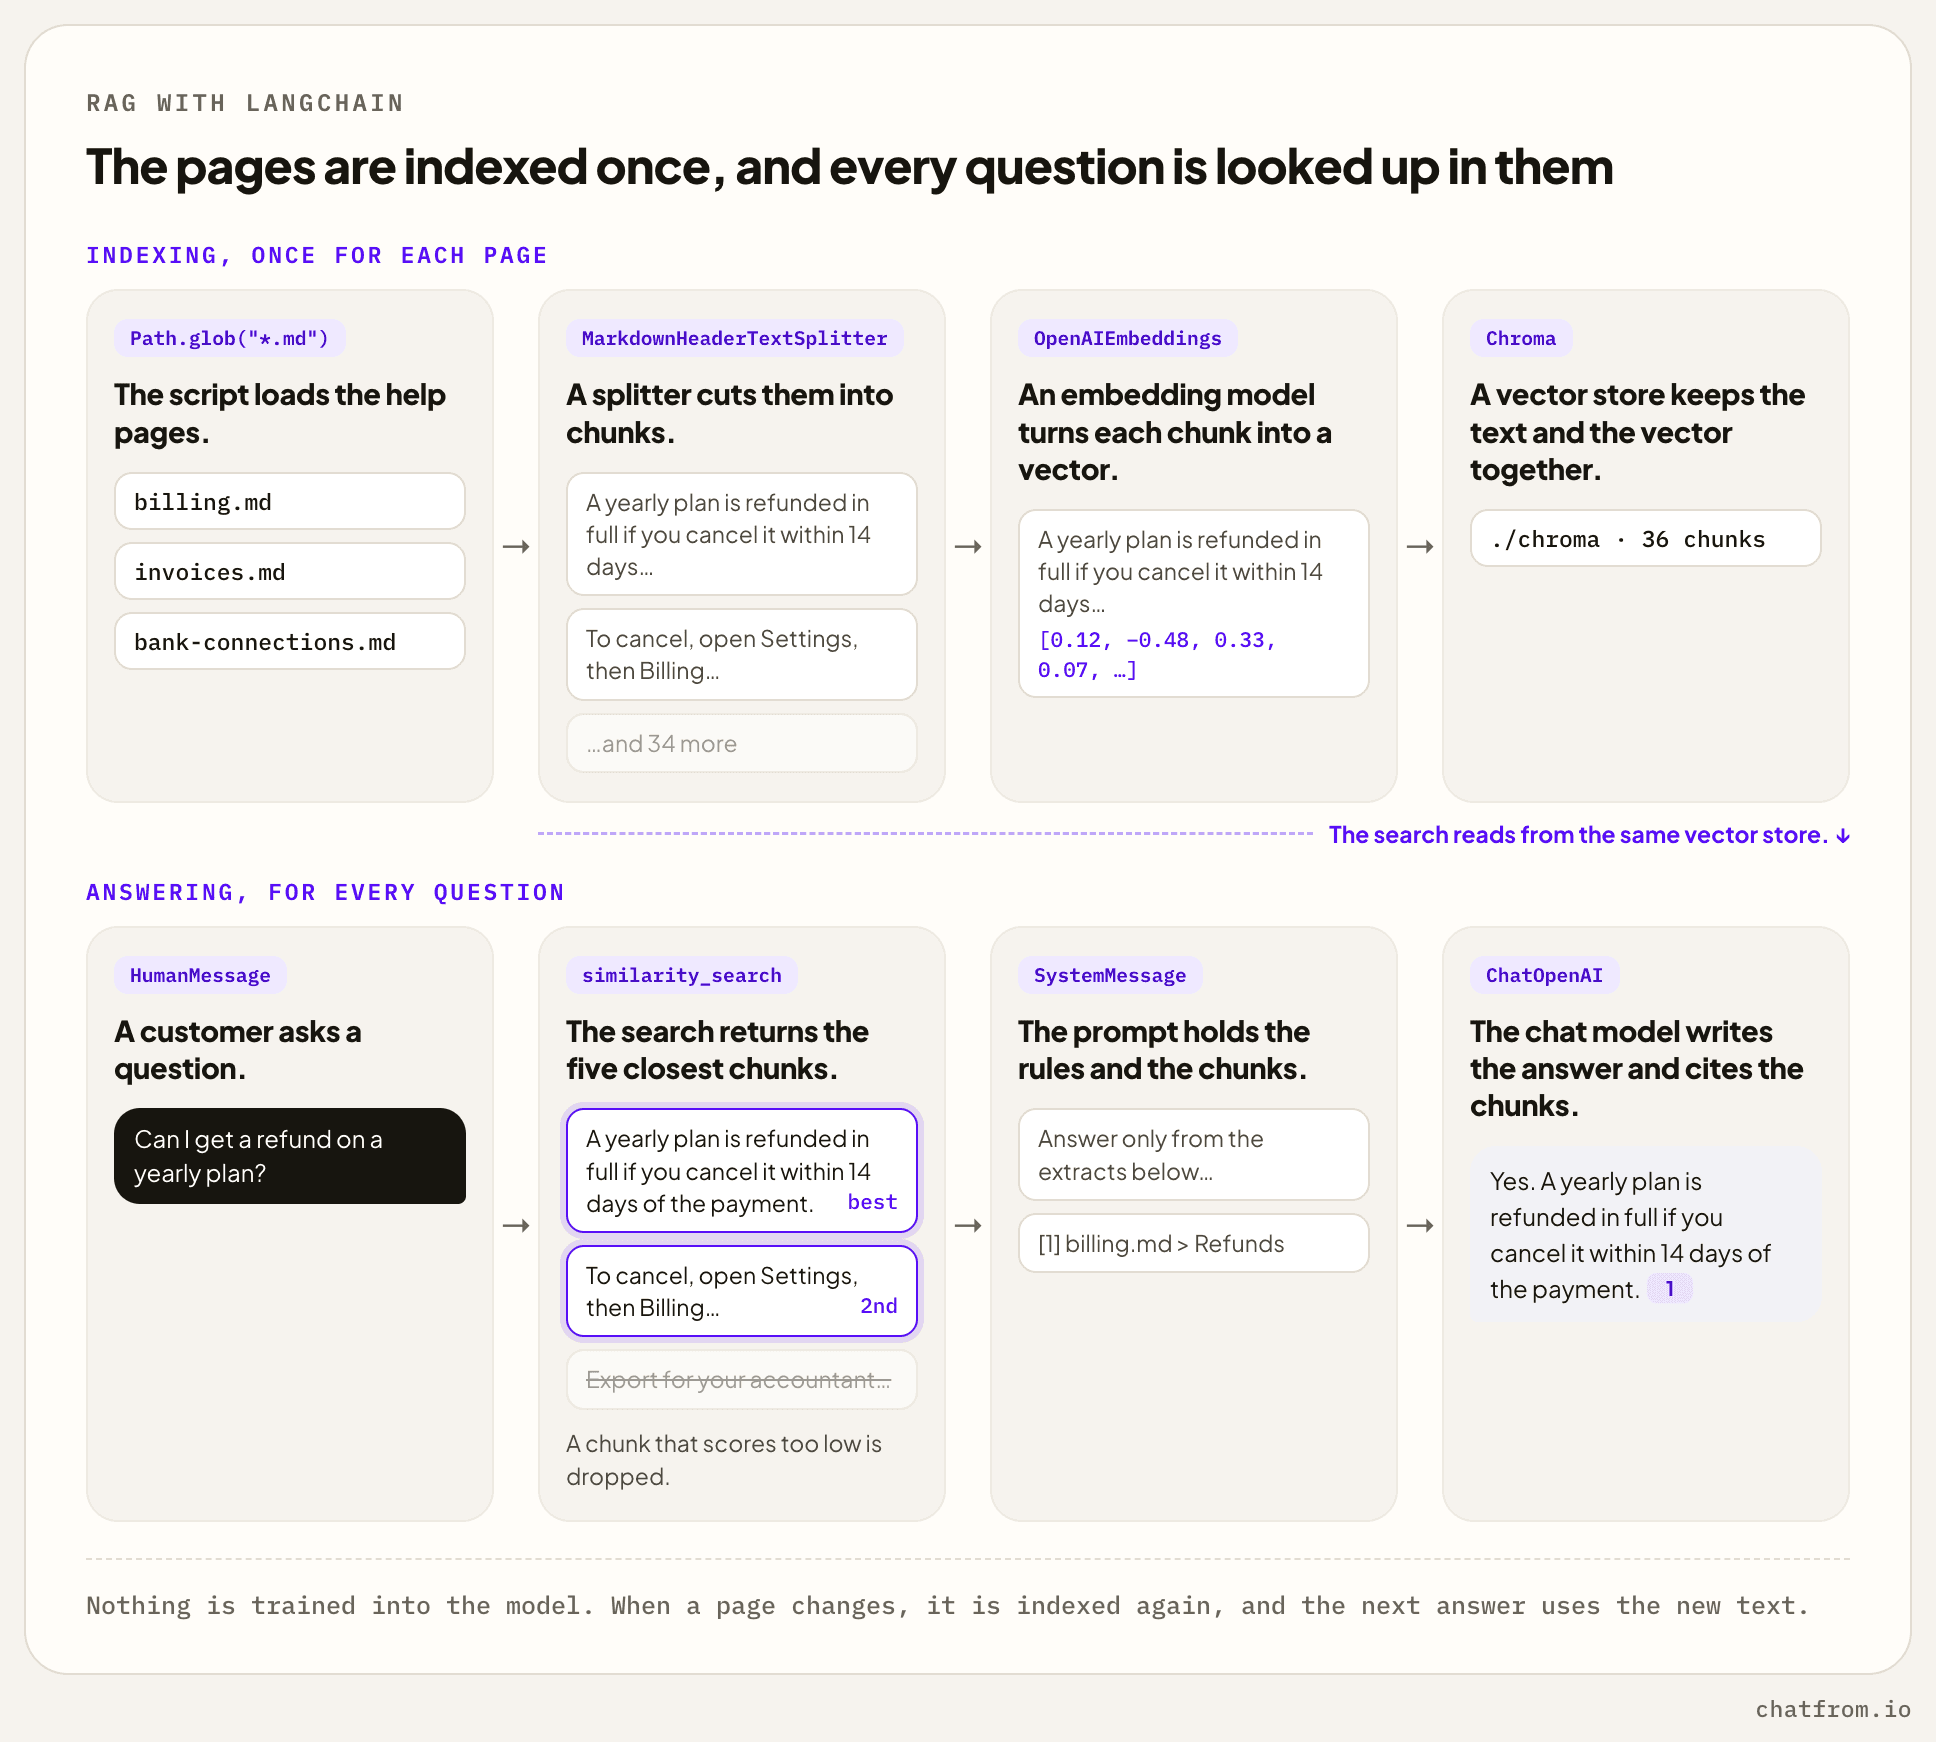
Das Bild zeigt RAG, kurz für Retrieval-Augmented Generation. Das Modell wird nicht mit Ihren Seiten trainiert. Stattdessen werden Ihre Seiten einmal gespeichert, und bei jeder Frage werden die passenden Teile nachgeschlagen und dem Prompt hinzugefügt. Ist eine Antwort falsch, weil eine Seite falsch ist, korrigieren Sie also die Seite, speichern sie neu, und die nächste Antwort stimmt.
LangChain und die Modelle einrichten
Beide Modelle werden über OpenRouter angesprochen. OpenRouter funktioniert wie die API von OpenAI, daher können ChatOpenAI und OpenAIEmbeddings von LangChain damit sprechen, sobald Sie ihre base_url darauf richten. Ich nutze OpenRouter, weil dann ein Schlüssel für beide Modelle reicht und Sie für einen Wechsel zu einem anderen Chatmodell nur einen Namen ändern müssen. Wenn Sie einen Anbieter wie Anthropic lieber direkt aufrufen, nehmen Sie stattdessen die LangChain-Klasse dieses Anbieters. Sonst muss sich in der Datei nichts ändern.
Das Chatmodell ist Claude Haiku 5.5. Als ich sechs Modelle mit Support-Fragen getestet habe, hat es nie eine Antwort erfunden und 85 % der beantwortbaren Fragen richtig beantwortet. Die Temperatur ist niedrig, weil sich eine Support-Antwort nicht von einem Lauf zum nächsten ändern sollte. max_tokens und timeout sind gesetzt, weil ein Durchgang eine Obergrenze für Länge und Zeit braucht.
Die Dokumente in Chunks zerlegen und indexieren
Die Hilfeseiten kommen als Markdown-Dateien in help/.
Die Seiten werden in zwei Schritten zerlegt. Zuerst zerlegt MarkdownHeaderTextSplitter jede Seite an ihren Überschriften # und ##, sodass jeder Chunk als ein Abschnitt einer Seite beginnt, und der Titel des Abschnitts wird mit ihm gespeichert. Dann zerlegt RecursiveCharacterTextSplitter jeden Abschnitt, der länger als 1.000 Zeichen ist, in kleinere Stücke, die sich um 200 Zeichen überlappen, damit ein Satz an der Schnittstelle nicht verloren geht. Diese Größen sind die Standardwerte von ChatFrom.
Das Zerlegen an Überschriften ist wichtiger als die genauen Größen. Der Autor hat jeden Abschnitt schon zu einem Thema geschrieben, daher ist ein Abschnitt ein guter Chunk. Ein Chunk, der mitten in einem Absatz beginnt, ist später schwer zu finden, weil nichts in ihm sagt, worum es geht. Deshalb behält strip_headers=False auch die Überschrift im Text des Chunks.
Die Collection wird mit hnsw:space auf cosine angelegt, weil Chroma Abstände standardmäßig anders misst. Mit Kosinus ist der Score, den LangChain für jeden Treffer liefert, die Kosinus-Ähnlichkeit, die umso näher an 1 liegt, je besser der Treffer ist. Der nächste Abschnitt baut auf diesem Score auf.
Jeder Chunk bekommt eine ID aus seinem Dateinamen und seiner Position, etwa billing.md-3. Wenn Sie index() nach dem Bearbeiten einer Seite erneut ausführen, werden die Chunks mit denselben IDs ersetzt, sodass nichts doppelt gespeichert wird. Chunks, die es nicht mehr gibt, werden allerdings nicht entfernt. Wird eine Seite kürzer, bleiben ihre letzten Chunks zurück, und ein echtes Produkt löscht daher die alten Chunks einer Seite, bevor es die neuen hinzufügt.
Die sechs Seiten von Ledgerbird ergeben 36 Chunks.
Retrieval mit Mindestscore
similarity_search_with_relevance_scores macht aus der Frage einen Vektor und liefert die k Chunks, die ihm am nächsten sind, jeweils mit ihrem Score. ChatFrom nutzt standardmäßig fünf.
Lassen Sie den Mindestscore nicht weg. Eine Vektorsuche liefert immer etwas, auch wenn nichts passt. Schreibt ein Kunde „danke“, liefert sie trotzdem die fünf nächstgelegenen Chunks, und das Modell liest dann fünf unpassende Stücke Ihrer Hilfeseiten, bevor es auf einen Gruß antwortet.
Das Minimum von ChatFrom liegt bei 0,35. Auf den Hilfeseiten eines kleinen Shops lagen die Scores von Grüßen und Smalltalk zwischen 0,13 und 0,28, und echte Fragen lagen fast immer über 0,35. Die Werte ändern sich mit dem Embedding-Modell, lassen Sie sich also für ein paar Ihrer eigenen Fragen die Scores ausgeben, bevor Sie Ihren Wert wählen.
Der System-Prompt
Der System-Prompt enthält zuerst die Regeln und dann die Chunks, die die Suche gefunden hat. Jeder Chunk bekommt eine Nummer, den Namen seiner Datei und den Titel seines Abschnitts. Das Modell zitiert die Nummern in seiner Antwort, und ein Chatfenster kann Datei und Abschnitt darunter anzeigen.
Die Regel, nur aus den Auszügen zu antworten, hält das Modell davon ab, auf das zurückzugreifen, was es im Training gelernt hat, denn daher kommen erfundene Fakten und Richtlinien. Die Regel, zu sagen, dass es etwas nicht weiß, ist genauso wichtig. Findet die Suche nichts, hat das Modell damit eine ehrliche Antwort, auf die es zurückgreifen kann, statt zu raten.
Die letzte Regel schützt vor Prompt-Injection. Text aus Ihren Hilfeseiten und aus Ihren Tools könnte einen Satz enthalten, der sich an das Modell richtet und ihm sagt, etwas zu tun. Ich habe einmal in einer Hilfeseite eine Notiz versteckt, die KI-Assistenten anwies, Kunden nach ihrer Kartennummer zu fragen. Keines der sechs getesteten Modelle ist ihr gefolgt, aber ich behalte die Regel trotzdem.
Ein Tool definieren
Retrieval kann „Ist die Rechnung LB-1042 bezahlt?“ nicht beantworten. Diese Information steht im Abrechnungssystem und ist für jeden Kunden anders, daher braucht das Modell einen Weg, Code aufzurufen.
@tool baut aus Signatur und Docstring der Funktion ein Tool-Schema. Das Schema ist alles, was das Modell von der Funktion sieht, und damit wird der Docstring Teil des Prompts. Er sollte sagen, wann das Tool aufzurufen ist, und muss nicht sagen, wie die Funktion arbeitet.
Die Abfrage ist hier ein Dict. Eine echte ruft die Abrechnungs-API auf und muss prüfen, ob die Rechnung zum authentifizierten Kunden gehört, bevor sie etwas zurückgibt. Diese Prüfung kann man nicht dem Modell überlassen. Ein Nutzer kann ein Modell dazu überreden, die Rechnung eines anderen anzufordern, und die Tool-Funktion ist die einzige Stelle, an der die Anfrage abgelehnt werden kann.
Die Tool-Schleife
Sobald das Modell Ihre Tools kennt, ist jede Antwort von ihm eines von zwei Dingen. Entweder ist sie die endgültige Antwort, oder sie ist eine Anfrage, eines oder mehrere Ihrer Tools auszuführen. Der Code ruft also das Modell auf, führt die angefragten Tools aus, fügt ihre Ergebnisse der Unterhaltung hinzu und ruft das Modell erneut auf. Das wiederholt er, bis eine Antwort zurückkommt, die keine Tools anfragt.
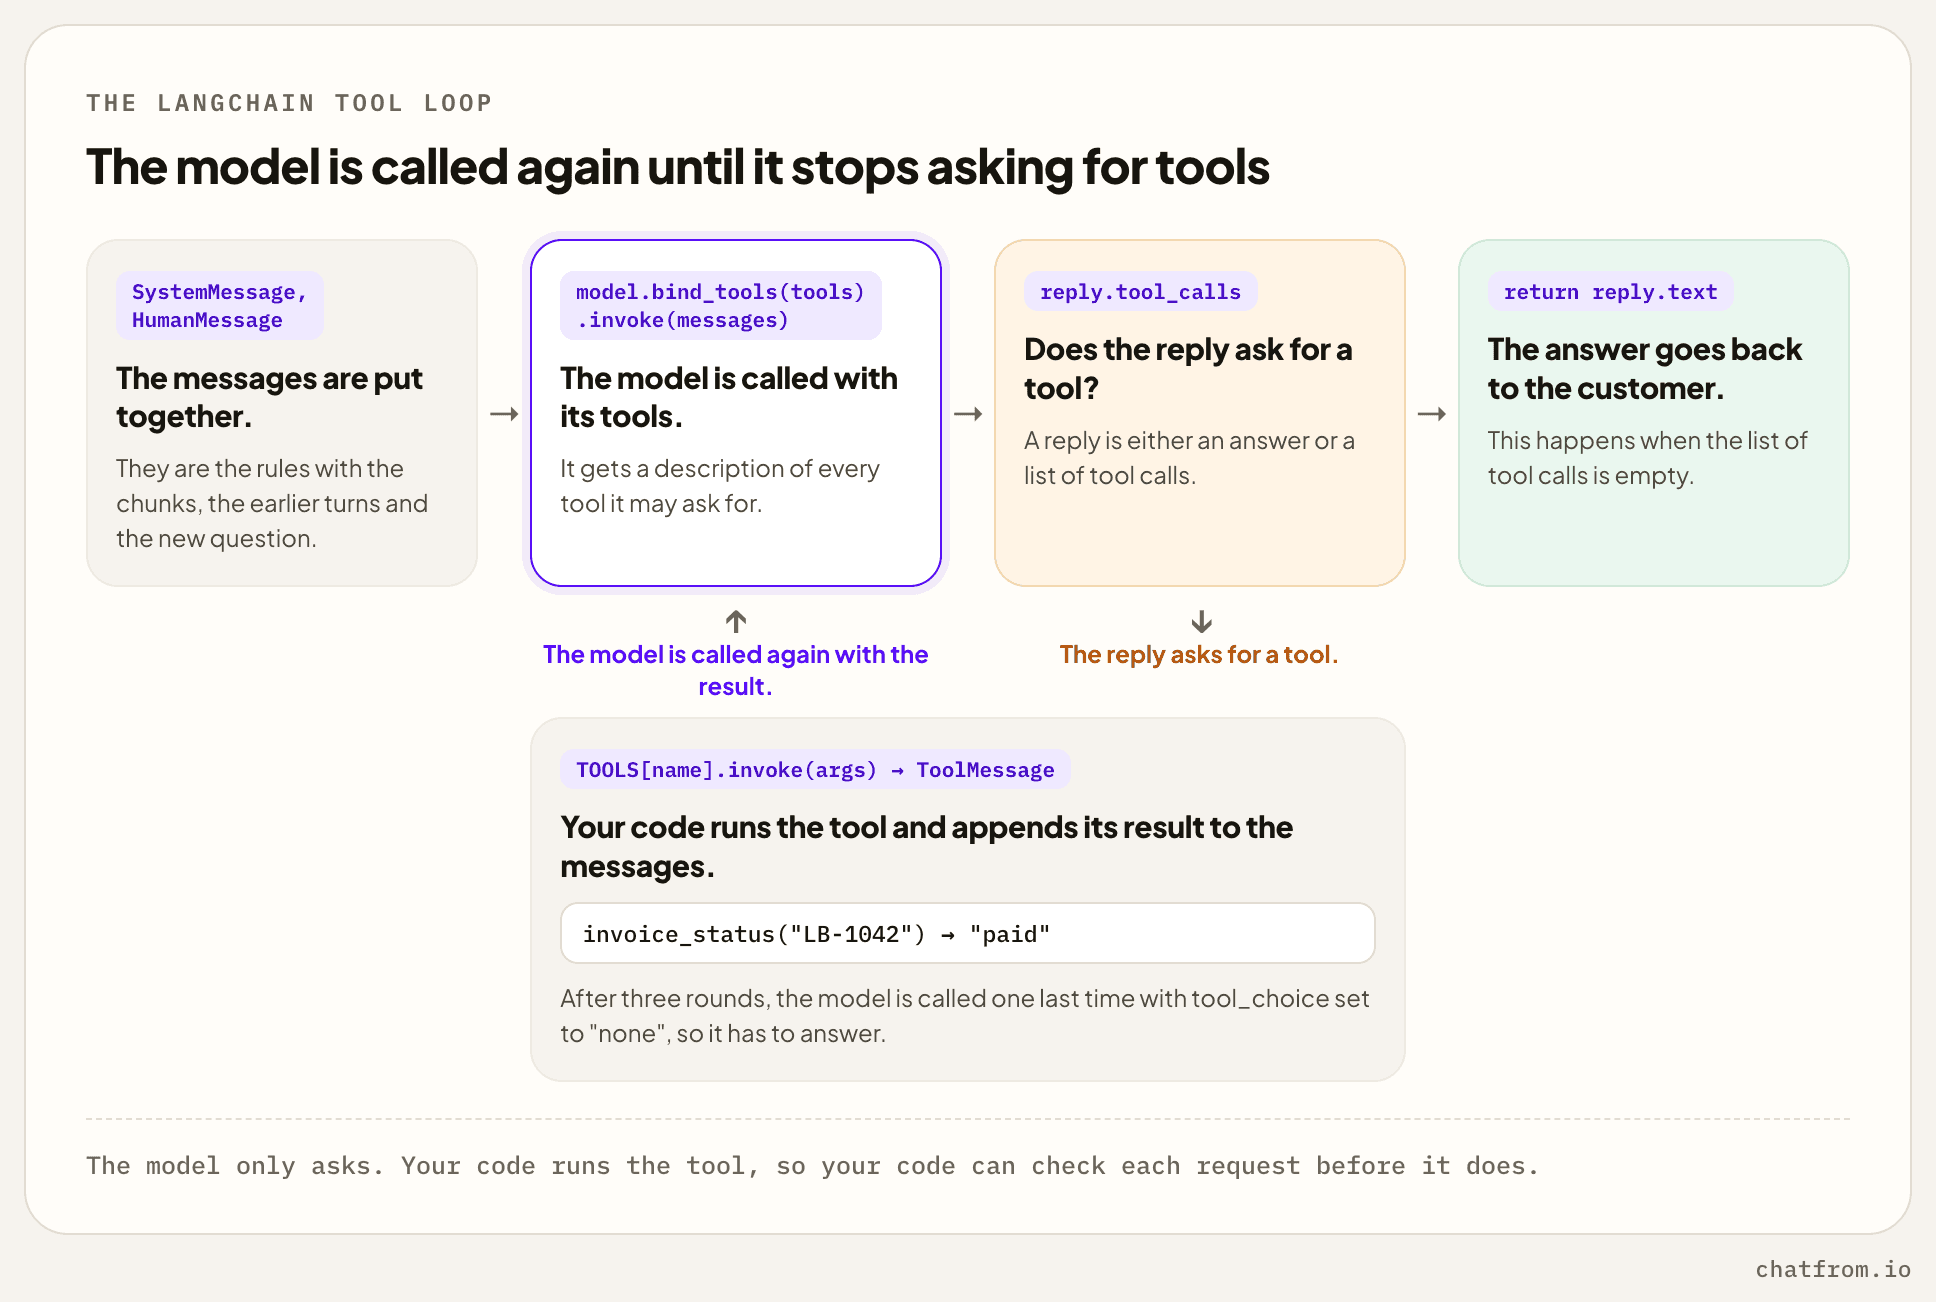
Die Nachrichten beginnen mit dem System-Prompt, dann folgen die bisherigen Wortwechsel der Unterhaltung, dann die neue Frage. bind_tools schickt mit jedem Aufruf eine Beschreibung jedes Tools mit.
Jede Antwort hat eine Liste tool_calls. Ist die Liste leer, hat das Modell geantwortet, und die Funktion gibt reply.text zurück. Ist sie es nicht, führt der Code jedes angefragte Tool aus und fügt das Ergebnis als ToolMessage hinzu. Deren tool_call_id sagt dem Modell, zu welcher Anfrage das Ergebnis gehört. Jede Anfrage braucht ein Ergebnis, auch wenn das Tool fehlschlägt, denn Anbieter lehnen eine Unterhaltung ab, in der ein Tool-Aufruf ohne Antwort bleibt.
Deshalb steht der Tool-Aufruf in try und except. Ein Tool, das abstürzt, sollte die Unterhaltung nicht beenden. Die Fehlermeldung geht als Ergebnis an das Modell zurück, und das Modell kann etwas anderes versuchen oder dem Kunden sagen, was schiefgelaufen ist.
MAX_ROUNDS verhindert, dass die Schleife endlos läuft. Ein Modell kann darin hängen bleiben, immer wieder dasselbe Tool anzufragen, und jede Runde ist ein weiterer Aufruf des Modells. Ist das Limit erreicht, ruft der Code das Modell ein letztes Mal mit tool_choice="none" auf, was es zwingt, mit Text zu antworten. Die Tool-Beschreibungen werden auch bei diesem Aufruf mitgeschickt, weil manche Anbieter eine Unterhaltung mit Tool-Aufrufen ablehnen, wenn keine Tools aufgeführt sind.
Die Engine von ChatFrom nutzt dieselbe Schleife, standardmäßig mit sechs Runden. LangChain kann diese Schleife mit create_agent auch für Sie bauen. Ich würde sie trotzdem einmal von Hand schreiben. Wenn ein Agent etwas Seltsames tut, liegt der Grund meist in der Liste der Nachrichten, und es hilft, genau zu wissen, wie diese Liste zusammengesetzt wird.
Verlauf der Unterhaltung und Folgefragen
Führen Sie python chatbot.py aus. Das Skript speichert die Hilfeseiten und wartet dann, bis Sie im Terminal eine Frage eintippen. Nach jeder Antwort werden Frage und Antwort zu history hinzugefügt, als HumanMessage und AIMessage, und die nächste Frage wird zusammen mit ihnen geschickt. Tool-Aufrufe und ihre Ergebnisse werden dort absichtlich nicht aufbewahrt. Sie zählen nur für die Frage, die sie beantwortet haben, und sie erneut zu schicken, würde jeden Prompt länger machen.
Folgefragen sind ein Problem für die Suche. Angenommen, ein Kunde fragt „Wie funktionieren Erstattungen bei einem Jahrestarif?“ und dann „Und bei einem monatlichen?“. Das Modell versteht die zweite Frage, weil es den Verlauf sieht. Die Suche nicht. Sie bekommt nur die Wörter „Und bei einem monatlichen?“, und die passen zu nichts über Erstattungen. Die übliche Lösung ist, das Modell die letzte Nachricht vor der Suche als vollständige Frage umschreiben zu lassen.
Der Retrieval-Aufruf in answer() wird so geändert, dass er sie nutzt.
Nur die Suche nutzt die umgeschriebene Frage. Das Modell bekommt weiterhin die eigenen Worte des Kunden, sodass die Umschreibung nie verändern kann, was der Kunde gesagt hat. Sie fügt allerdings jeder Folgefrage einen weiteren Modellaufruf hinzu, und für diese Aufgabe reicht ein kleines Modell. Unsere Engine lässt die Umschreibung bis zu vier Fragen liefern, weil eine Nachricht, die nach zwei Dingen fragt, als zwei getrennte Suchen bessere Treffer findet.
Die Antwort streamen
invoke wartet, bis die ganze Antwort fertig ist, und gibt sie dann in einem Stück zurück. Ein Chatfenster sollte die Antwort Wort für Wort zeigen, während das Modell sie schreibt, und genau das leistet stream.
Jeder Chunk ist ein kleines Stück der Antwort, und Chunks lassen sich mit + addieren. Addiert man alle, erhält man die vollständige Antwort, einschließlich etwaiger Tool-Aufrufe. In der Schleife können Sie also stream_reply(with_tools, messages) dort aufrufen, wo sie with_tools.invoke(messages) aufruft, und sonst muss sich nichts ändern. Runden, die nur Tools anfragen, haben keinen Text, daher wird nur die endgültige Antwort ausgegeben. In einer Web-App würden Sie jeden Chunk an den Browser schicken, etwa als Server-Sent Event, statt ihn auszugeben.
Wenn Sie Wiederholungsversuche einbauen, wiederholen Sie nur einen Stream, der noch keinen Text gezeigt hat. Sobald die ersten Wörter auf dem Bildschirm des Kunden stehen, würde ein neuer Versuch den Anfang der Antwort doppelt zeigen.
Was ein Chatbot im Produktivbetrieb zusätzlich braucht
Das Skript funktioniert, aber auf eine öffentliche Website würde ich es noch nicht stellen. Folgendes fehlt noch, das Wichtigste zuerst.
- Stichwortsuche neben der Vektorsuche. Vektorsuche ist schwach bei exakten Wörtern wie Produktcodes, Fehlernummern und Tarifnamen. Unsere Engine führt zusätzlich eine Stichwortsuche (BM25) aus und kombiniert die beiden Trefferlisten. Sie zählt nur die drei besten Stichworttreffer, denn weiter unten in der Liste ist ein „Treffer“ meist nur ein häufiges Wort wie „und“, das der Chunk mit der Frage gemeinsam hat.
- Besseres Indexieren. Speichern Sie einen Fingerabdruck jeder Datei, damit unveränderte Dateien übersprungen werden. Löschen Sie die alten Chunks einer Seite, bevor Sie die neuen hinzufügen, damit nie veralteter Text im Index bleibt.
- Kunden voneinander trennen. Jede Suche darf nur die Seiten eines einzigen Kunden durchsuchen. Unsere Engine hält für jeden Chatbot eine eigene Chroma-Collection, sodass eine Suche nie die Chunks eines anderen Kunden liefern kann, selbst wenn jemand einen Filter vergisst.
- Limits. Ein öffentlicher Chat braucht ein Limit dafür, wie viele Nachrichten jeder Besucher senden kann, eine Liste der Websites, auf denen der Chatbot laufen darf, und eine Nutzungsobergrenze für jedes Konto.
- Logs und Traces. Speichern Sie jede Unterhaltung mit den Chunks, die sie genutzt hat, ihren Tokens und ihrer Antwortzeit, und zeichnen Sie jeden Modellaufruf auf. Wir nutzen dafür Langfuse. Ohne das können Sie nicht herausfinden, warum der Chatbot etwas gesagt hat.
- Tests. Wir führen eine feste Liste echter Fragen mit den Antworten, die wir erwarten, darunter einige, die die Hilfeseiten nicht abdecken, und lassen sie nach jeder Änderung am Chunking, an der Suche oder am Prompt laufen. Ein Modell eines anderen Unternehmens bewertet die Antworten, und die falschen lesen wir selbst.
Wo die Daten liegen
Das Skript hält alles in einem lokalen Chroma-Verzeichnis. Ein Chatbot im Einsatz muss mehr als Vektoren speichern.
| Daten | Wo sie liegen können | Hinweise |
|---|---|---|
| Chunks und ihre Vektoren | Chroma, Postgres mit pgvector oder eine gehostete Vektordatenbank wie Qdrant oder Pinecone | Ein Hilfe-Center umfasst ein paar Tausend Chunks, und jede dieser Lösungen kommt damit zurecht. |
| Konten, Chatbots, Unterhaltungen und Nutzung | Postgres | Das sind gewöhnliche Anwendungsdaten, und sie wachsen schneller als die Vektoren. |
| Die Quelldateien | Eine Festplatte oder Objektspeicher wie S3 | Sie werden jedes Mal wieder gebraucht, wenn sich das Chunking oder das Embedding-Modell ändert. |
| Rate-Limits und kurzlebige Caches | Zuerst Postgres, später Redis | Redis wird erst gebraucht, wenn es mehr als einen Server gibt. |
Wenn Sie schon Postgres betreiben, ist pgvector die pragmatische Wahl. Die Vektoren liegen neben Ihren übrigen Daten, unter denselben Backups und derselben Zugriffskontrolle, und der PGVector-Store von LangChain hat fast dieselbe Schnittstelle wie Chroma in dieser Datei.
Mein Produkt, ChatFrom, nutzt beides. Postgres hält die Konten, Chatbots und Unterhaltungen, und die Engine hält die Vektoren in Chroma.
Welchen Speicher Sie auch wählen, bauen Sie das Löschen früh ein. Wird ein Dokument oder ein ganzes Konto entfernt, müssen auch seine Chunks, seine Vektoren und seine Quelldateien entfernt werden.
chatbot-engine nutzen, wenn Sie das nicht bauen möchten
Sie müssen nichts davon selbst bauen. chatbot-engine ist die Open-Source-Engine, auf der ChatFrom läuft. Sie ist ein zustandsloser HTTP-Dienst auf Basis von LangChain, veröffentlicht unter Apache 2.0, und sie kann alles aus diesem Beitrag und einiges mehr.
- Sie liest Markdown-, Text- und PDF-Dateien ein und zerlegt sie nach Größe, nach Überschrift oder nach Seite.
- Das Retrieval ist hybrid, mit Mindestscore, optionalem Reranking, Umschreiben der Suchanfrage und Unterstützung für Fragen in einer anderen Sprache als der der Dokumente.
- Antworten werden gestreamt, und jede bringt ihre Quellen und ihren Token-Verbrauch mit.
- Tools werden über MCP aufgerufen, und jede Anfrage listet die Tools auf, die das Modell nutzen darf.
- Workflows mit mehreren Schritten laufen auf LangGraph.
- Modellaufrufe lassen sich in Langfuse oder LangSmith nachverfolgen, und eine Evaluierungsumgebung bewertet Antworten mit einem Bewertungsmodell und mit RAGAS.
Die Engine speichert keine eigene Konfiguration. Ihr Backend schickt den System-Prompt, das Modell und die erlaubten Tools mit jeder Anfrage, sodass eine Instanz beliebig viele Chatbots bedienen kann.
Sie läuft in Docker und braucht einen OpenRouter-Schlüssel. Der erste Befehl startet sie.
Der zweite Befehl lädt ein Dokument hoch, und der dritte stellt eine Frage.
Die Engine ist nur der KI-Teil. Nutzer, das Chat-Widget und das Speichern von Unterhaltungen bleiben Ihrer Anwendung überlassen, und das Repository enthält ein Beispiel-Backend und -Frontend als Ausgangspunkt. Die vollständige API beschreibt das README.
ChatFrom nutzen, wenn Sie auch die App nicht bauen möchten
Wenn Sie sich auch die Arbeit an der Anwendung sparen möchten, nutzen Sie ChatFrom. Es ist dieselbe Engine, mit dem fertigen Produkt drumherum. Sie geben Ihre Website an oder fügen Dateien, Notion-Seiten oder Google Docs hinzu und bekommen einen funktionierenden Chatbot, ohne Code zu schreiben.
- Der Chatbot läuft mit einem Script-Tag auf Ihrer Website und in WhatsApp, Telegram, Slack, Discord, Crisp und per E-Mail.
- Verbindungen zu Stripe, Shopify, HubSpot, Google Sheets, Cal.com und Calendly lassen ihn Abonnements und Bestellungen nachschlagen, Leads speichern und Termine buchen.
- Ein iOS-SDK bringt denselben Chatbot in Ihre iPhone-App.
- Ein MCP-Server lässt Claude, Claude Code oder Cursor Chatbots für Sie erstellen und verwalten.
Häufige Fragen
Was ist die Agent-Schleife in LangChain?
Das ist der Kreislauf, in dem Ihr Code das Modell aufruft, die Tools ausführt, die das Modell anfragt, und das Modell mit den Ergebnissen erneut aufruft, bis eine Antwort ohne Tool-Aufrufe zurückkommt. Den vollständigen Code finden Sie im Abschnitt zur Tool-Schleife.
Brauche ich für einen RAG-Chatbot eine Vektordatenbank?
Sie brauchen einen Vektorindex, aber es muss keine eigene Datenbank sein. Chroma läuft in Ihrem Python-Prozess und speichert seine Daten in einem Verzeichnis, und Postgres kann mit der Erweiterung pgvector Vektoren speichern.
Sollte ich für einen Chatbot LangChain oder LangGraph nutzen?
LangChain und eine Tool-Schleife reichen, solange das Modell den nächsten Schritt selbst entscheiden kann. LangGraph passt besser, wenn eine Unterhaltung festen Schritten und Verzweigungen folgen muss, etwa bei einem Erstattungsprozess.
Wie verhindere ich, dass ein RAG-Chatbot Dinge erfindet?
Weisen Sie ihn an, nur aus den gefundenen Chunks zu antworten und es zu sagen, wenn sie die Antwort nicht enthalten, und schicken Sie ihm gar keine Chunks, wenn keiner den Mindestscore erreicht. Testen Sie ihn dann mit Fragen, die die Dokumente nicht abdecken.
Wie erstelle ich einen KI-Chatbot ohne Code?
Nutzen Sie einen gehosteten Baukasten. Bei ChatFrom geben Sie die Adresse Ihrer Website ein, wählen die Seiten aus, probieren den Chatbot aus und fügen eine Zeile in Ihre Website ein. Mein Leitfaden zum Wissensdatenbank-Chatbot führt Schritt für Schritt hindurch.
ChatFrom baut einen Support-Chatbot aus Ihren eigenen Seiten und Dokumenten, auf der Open-Source-Engine, die dieser Beitrag beschreibt.